RAG, fine-tuning eller long context?
Skal AI’en kende jeres data – eller lære at opføre sig anderledes?
RAG, fine-tuning og long context bliver ofte omtalt som tre alternative måder at gøre en sprogmodel bedre på. Det er misvisende. De løser forskellige problemer – og i en god virksomhedsarkitektur bliver de ofte kombineret.
Det afgørende er derfor ikke at vælge den mest avancerede teknik. Det er at forstå, hvor jeres problem ligger: mangler modellen aktuel viden, skal den følge en bestemt adfærd, eller skal den kunne arbejde med en stor, afgrænset mængde materiale her og nu?
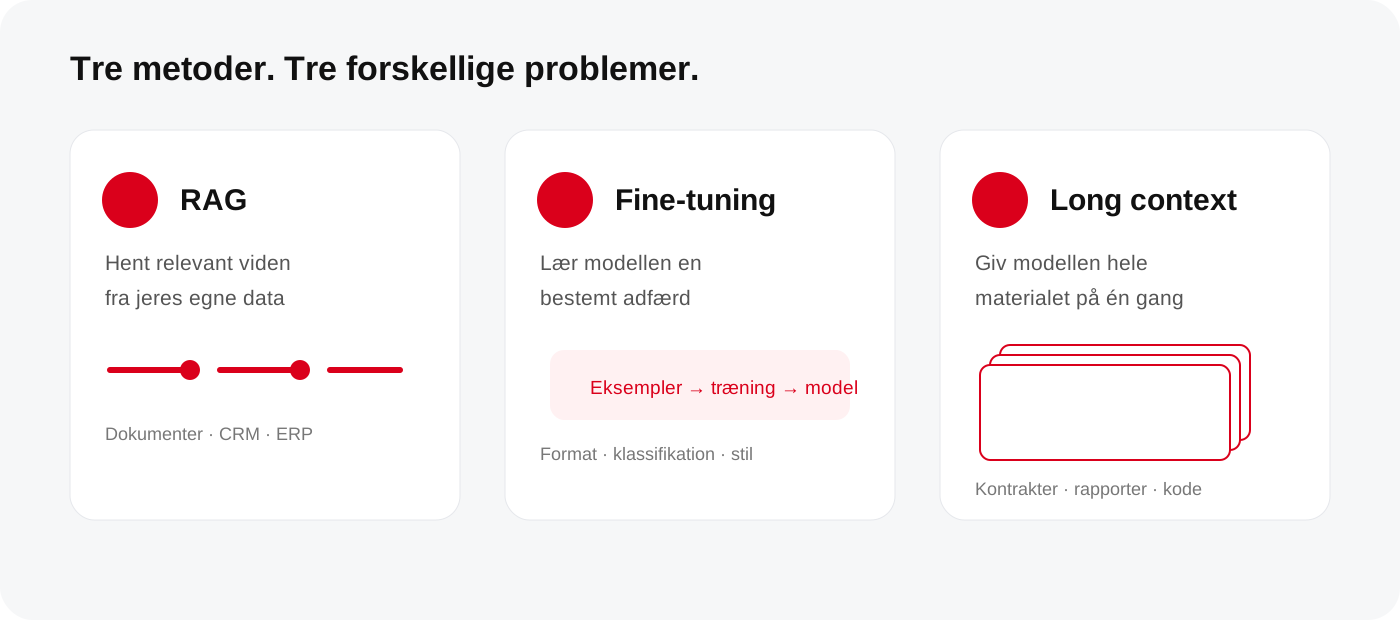
Kort fortalt: forskellen på de tre
RAG – når AI skal bruge jeres aktuelle viden
RAG står for Retrieval-Augmented Generation. Før modellen svarer, finder løsningen relevante oplysninger i eksempelvis SharePoint, dokumenter, CRM, ERP, produktdata eller en vidensbase. Kun det relevante materiale sendes videre til modellen som kontekst.
Fine-tuning – når modellen skal lære en bestemt adfærd
Ved fine-tuning trænes modellen videre på eksempler fra den opgave, den skal løse. Det kan være klassifikation, et bestemt outputformat, en særlig skrivestil eller en meget stabil og gentagen beslutningsopgave. Fine-tuning er derimod sjældent den rigtige database til virksomhedens løbende viden.
Long context – når hele materialet kan gives med på én gang
Moderne modeller kan arbejde med meget store kontekstvinduer. Det gør det muligt at sende en rapport, en kontraktpakke eller en større kodebase direkte med i forespørgslen. Det er enkelt og stærkt til afgrænsede opgaver, men er ikke automatisk den bedste løsning til en levende virksomhedsviden.
Hvad skal I vælge?
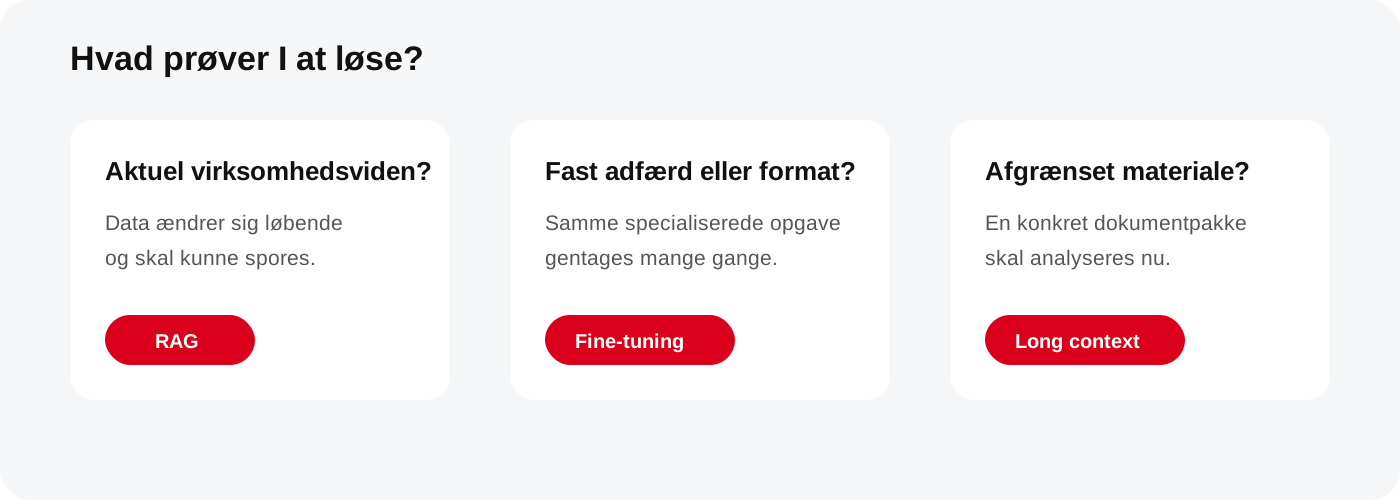
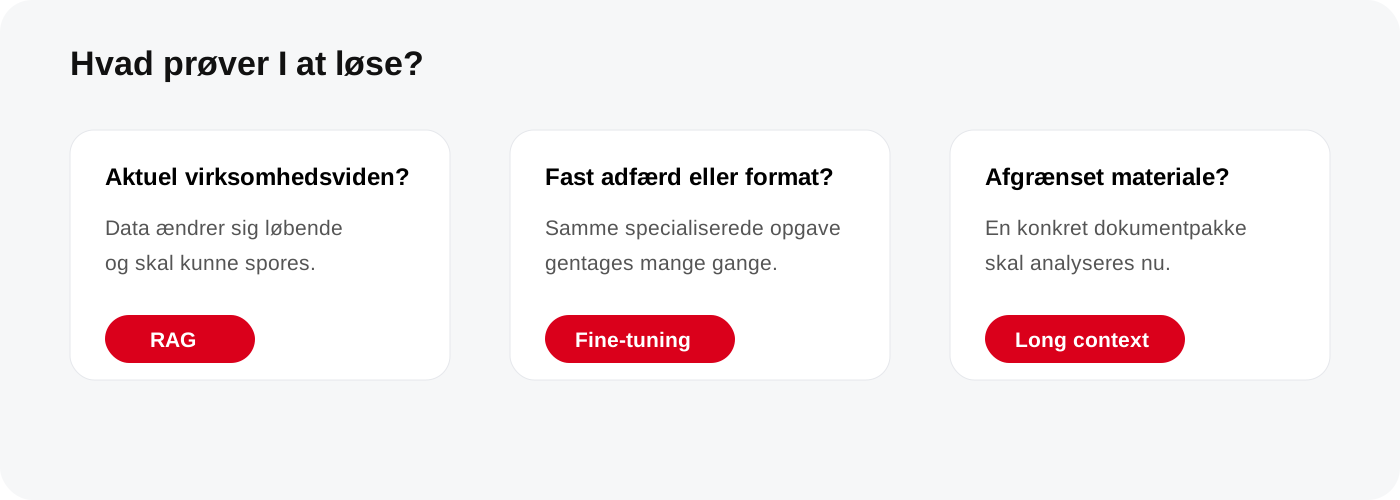
En praktisk måde at vælge på er at starte med den type problem, I faktisk prøver at løse.
1. “AI’en skal svare ud fra vores dokumenter og systemer” → RAG
Forestil jer en intern assistent til serviceafdelingen. Medarbejderen spørger: “Hvad er garantibetingelserne på produkt X, og har denne kunde en aktiv serviceaftale?” Svaret kræver både dokumentation og aktuelle kundedata. Her giver RAG mening, fordi løsningen kan hente de relevante kilder i det øjeblik spørgsmålet stilles.
Fordelen er ikke kun aktualitet. Arkitekturen kan også bevare relationen til kilden, så brugeren kan se, hvor oplysningerne kommer fra. Det gør svarene lettere at kontrollere og løsningen lettere at vedligeholde.
2. “AI’en gør næsten det rigtige, men outputtet er ustabilt” → Fine-tuning
Forestil jer tusindvis af supporthenvendelser, der altid skal klassificeres efter virksomhedens egne kategorier og returneres i et helt bestemt format. Hvis gode prompts og struktureret output ikke er stabile nok, kan fine-tuning være relevant.
Her lærer modellen mønsteret gennem eksempler. Men hvis kategorier, priser eller produktregler ændrer sig hver uge, bør de stadig ligge uden for modellen. Adfærd kan trænes; levende forretningsdata bør normalt hentes.
3. “AI’en skal analysere denne konkrete bunke materiale” → Long context
Hvis opgaven er at sammenholde eksempelvis 12 kontrakter, et udbudsmateriale eller dokumentationen til ét projekt, kan long context være den enkleste arkitektur. Materialet gives direkte til modellen, som kan opsummere, sammenligne og finde uoverensstemmelser.
Når datamængden vokser, bruges igen og igen eller kræver adgangsstyring på tværs af brugere, bliver RAG typisk mere interessant.
Sammenligning: RAG vs. fine-tuning vs. long context
Opdateret virksomhedsviden
RAG: stærk. Fine-tuning: svag som videnslager. Long context: stærk, hvis materialet kan sendes med i den konkrete opgave.
Kildehenvisninger og sporbarhed
RAG: kan knytte svaret til de fundne kilder. Fine-tuning: vanskeligere at dokumentere, hvor en konkret oplysning kommer fra. Long context: muligt, fordi kilderne ligger i konteksten, men kræver stadig god promptning og evaluering.
Stabil adfærd og format
RAG: ændrer primært modellens informationsgrundlag. Fine-tuning: stærk, når modellen skal lære gentagne mønstre. Long context: afhænger fortsat i høj grad af instruktioner og modellens generelle adfærd.
Vedligeholdelse
RAG: data kan opdateres uden at træne modellen igen. Fine-tuning: nye adfærdsmønstre kræver nye træningsdata og typisk en ny træning. Long context: enkelt ved enkeltstående opgaver, men dyrt og upraktisk hvis den samme store datamængde sendes igen og igen.
Typisk førstevalg
Virksomhedsviden → RAG. Gentagen specialiseret adfærd → fine-tuning. Afgrænset analyse af en stor dokumentpakke → long context.
Det interessante er ofte kombinationen
I praksis er arkitekturen sjældent et rent valg mellem tre kasser. En løsning kan bruge RAG til at hente de fem mest relevante dokumenter, sende dem ind i modellens long context og samtidig bruge en fine-tunet model, der er trænet til virksomhedens klassifikation eller outputformat.
Et eksempel kunne være en AI-assistent til tilbudsarbejde: RAG finder tidligere tilbud, produktbeskrivelser, priser og kundedata. Long context giver modellen plads til at arbejde med det aktuelle udbudsmateriale. Fine-tuning kan eventuelt bruges, hvis outputtet skal følge en meget specifik struktur, som almindelige instruktioner ikke leverer stabilt nok.
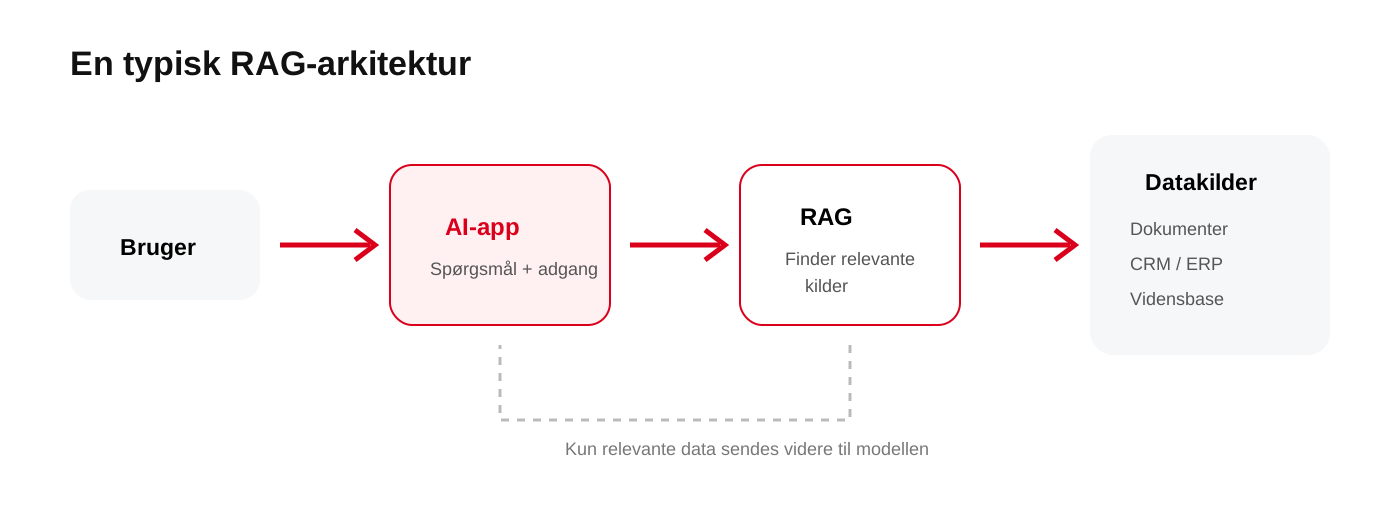
Sådan ser en typisk RAG-arkitektur ud
Brugeren skriver til en AI-applikation. Løsningen identificerer behovet, søger i de datakilder brugeren har adgang til og henter kun de relevante bidder. De sendes sammen med spørgsmålet til modellen. Svaret returneres med reference til kilderne.
Det vigtige er, at AI-laget ikke må blive en genvej uden om virksomhedens sikkerhed. Hvis en medarbejder ikke må læse en mappe, en kundesag eller et økonomidokument i kildesystemet, skal AI’en heller ikke kunne hente det.
RAG er heller ikke bare “læg dokumenterne i en vector database”
En god RAG-løsning afhænger mindst lige så meget af datakvalitet og retrieval som af selve sprogmodellen. Dokumenter skal opdeles fornuftigt, metadata skal bevares, søgningen skal kombinere de rigtige signaler, og løsningen skal vide, hvornår den ikke har fundet et godt nok grundlag til at svare.
Derfor bør evalueringen teste hele kæden: fandt vi den rigtige kilde, brugte modellen den korrekt, blev adgangsregler respekteret, og kunne løsningen afvise spørgsmålet, når datagrundlaget var utilstrækkeligt?
Hvad med pris og hastighed?
Long context ser attraktivt ud, fordi arkitekturen er enkel: send mere tekst til modellen. Men store prompts skal behandles ved hver forespørgsel og kan derfor påvirke både svartid og tokenforbrug. RAG tilføjer til gengæld infrastruktur til indeksering, søgning og adgangsstyring, men reducerer ofte den mængde materiale, modellen behøver at læse.
Fine-tuning har en anden økonomi. Der er arbejde i at skabe og kvalitetssikre træningsdata, gennemføre træningen og evaluere den nye modelversion. Til gengæld kan en specialiseret model i nogle scenarier løse en meget stabil opgave mere effektivt.
Der findes derfor ikke én universelt billigst arkitektur. Omkostningen skal vurderes på den samlede løsning: udvikling, drift, modelkald, dataintegrationer, evaluering og den forretningsværdi løsningen skaber.
Vores tommelfingerregel
Start ikke med teknologien. Start med de spørgsmål løsningen skal kunne besvare og de handlinger, den skal kunne udføre.
Hvis svaret afhænger af information, der ændrer sig → hent den. Hvis problemet er modellens gentagne adfærd → overvej at træne den. Hvis opgaven består af en afgrænset mængde materiale → prøv long context først.
Og kombiner dem, når det giver mening. Den bedste AI-arkitektur er sjældent den mest avancerede. Det er den, der giver et korrekt, kontrollerbart og økonomisk fornuftigt svar på den konkrete opgave.
Vi bygger AI oven på de systemer, I allerede har
Hos Uptime bygger vi AI-løsninger, der kobler modeller sammen med virksomhedens eksisterende software, data og arbejdsgange. Det kan være RAG på tværs af dokumenter og fagsystemer, AI-agenter med adgang via API’er eller MCP-servere eller specialiserede løsninger, hvor klassisk software og AI arbejder sammen.
Målet er ikke at få mest mulig AI ind i arkitekturen. Målet er at bygge den enkleste løsning, der skaber reel værdi – og som I kan stole på i drift.
Kontakt os
Få bygget software der holder i drift
Kontakt os for en snak om, hvordan vi kan hjælpe jer i mål med jeres næste IT-projekt.
Fortæl os kort om jeres udfordring, så vender vi tilbage med vores vurdering og forslag til næste skridt.


